Hello AI with Jia
@XChatScout • 7,764 subscribers
AI 工具实测|大模型 & Agent|开源项目研究|数据可视化|项目投研|每天分享一点 AI 新发现
Shorts


Videos

1:13
Sensitive content
This media may contain sensitive content.
萤火虫漫展女cos被骚扰事件! 女cos坐在汽车上让人拍照,现场发生被摸脚的情况,女孩事后说自己是被骚扰,已经报警了。正面拍摄的视频显示,女孩表情自然的在拍摄出片!
Hello AI with Jia3,434,542 просмотров • 5 месяцев назад


1:00
Sensitive content
This media may contain sensitive content.


这不得让 Claude 舞一个 🕺 做了一段段 MV,我用 Flatkey 的 API 调用 Claude 来写代码,给 Claude Code 里的像素小家伙安排了一场深夜演出。蓝紫色星空、音乐频谱、跳动的歌词,再配上终端界面,还真有点“软件下班后偷偷开演唱会”的意思。 音频和 SRT 歌词作为素材,交给 Claude 编写 HTML/GSAP 代码动效,组织画面、字幕和角色动画,最后渲染成 MP4,不用 AI 生图。 软件界面成了一个舞台,像素角色住在里面,歌词也参与推进故事。提示词里,打字、删了重打、已读不回、弹窗,都被列进了表达情绪的界面动作。熟悉的软件操作,放进歌词对应的场景里,就有了另一层意思。 镜头和节奏也写进了提示词:开场先给主角近景,再拉远到完整界面;歌词逐字弹出,带红蓝分离;角色踩着节拍落地,脚下扩散水波;换场用像素块,反转的位置加速度线、问号和突然拉近的镜头。 这些要求落到角色、字幕、镜头各自的动作上,预览时就有了具体的调整依据。字幕挡住主体,可以改位置;角色动作太弱,可以改幅度;转场影响歌词阅读,可以改时机。一次修改围绕一个明确的效果展开,反馈也更容易说清楚。 提示词里的制作流程分成几个阶段:先分析 BPM、列逐句分镜,确认方向后做样片,再进入完整版。 歌词以提供的 SRT 为准,要求逐字对齐。先把视觉风格和节奏确认下来,后面的画面沿着同一套设计继续做。 有时间想把这套流程整理成 skills,把分镜要求、动效约定和检查项一起留下来。以后换首歌、换个主角、换个软件界面,就能沿着现有思路继续玩。每次做出的作品,也能给下一次积累一些可复用的东西。 这次作品用到了 Flatkey 接入的 Claude。平台支持 100+ 官方模型,覆盖文本、图片、视频和音频,并可接入 1,000+ 工具 API。模型与工具共用一个 API Key,费用汇总在同一张账单。 后续需要扩展多模态创作,也可以通过 Flatkey CLI,让 Claude Code 或 Codex 调用模型生成图片、视频和音频,按作品的需求选择模型。 目前 Flatkey 正在做上线活动,GPT 享 6 折,Claude 享 8 折,优惠持续至 10 月 23 日。继续写代码、练 skills、做这类小作品,也可以把调用成本一起算进去。 官方模型,更好价格。 想自己动手做点东西,可以从官网查看模型、价格和接入方式。 #flatkeyai
Hello AI with Jia12,026 просмотров • 9 дней назад
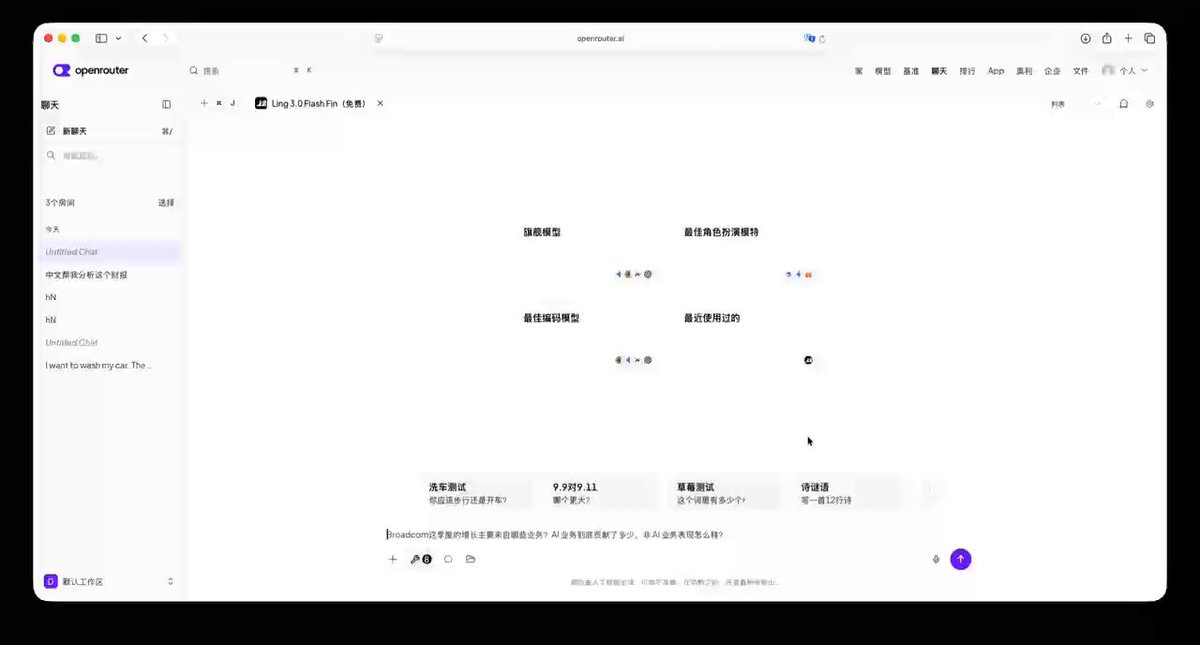
最近在看 Broadcom,所以最新财报出来后,我直接拿来测了下 Ling-3.0-flash-Fin。 我比较想知道的是:AI 业务涨得这么快,Broadcom 现在的增长到底有多依赖 AI? 这次没有让模型简单总结财报,而是让它顺着半导体、AI 收入、软件业务、利润和现金流一路拆下去,同时核对数据来源和口径。 最后给出的判断比较清楚: Broadcom 这季度增长很强,AI 已经成了最明显的驱动力,现金流表现也不错。 但隐患也很明显——如果后面的增长越来越集中在 AI 加速器和网络需求上,那就要继续看这种高强度需求到底能维持多久。 这也是 Ling-3.0-flash-Fin 比较有意思的地方。 它不是只回答一个金融问题,而是会把检索、分析、计算和结果整理串起来,最后给出可以复核的结论和风险提示。 它基于 Ling-3.0-flash 继续做金融增强,依旧是 124B 总参数、5.1B 激活参数。 这次比较让我意外的是,它对财务数据之间关系的处理,明显更像在真正做研究:不会看到一个高增长数字就停下来,而是会继续追收入结构、利润、现金流和潜在风险。 至少从这次 Broadcom 财报测试来看,它的金融增强,不只是“更懂几个金融术语”。 Ling-3.0-flash-Fin 试试,大家现在可以直接在 OpenRouter 上体验: 开源地址: 以上仅为模型测试,不构成任何投资建议。
Hello AI with Jia34,101 просмотров • 1 месяц назад

用 Ling-3.0-flash-VL 做了个图文识别小工具。 功能很简单:图片丢进去,直接识别里面的文字、数字、公式,同时尽可能保留原来的排版和内容关系。 为了看看它处理复杂图片到底怎么样,测试素材故意选得杂了一点: • 数学论文:正文、公式、上下标、希腊字母混排 • IDE:小字号代码、Terminal 输出、各种符号 • 图表:表格、数字、文字挤在一起 • 暗光菜单:低对比度、中英文混排 • 手写笔记:字形不标准、排版随意 • 发票:字段密集,而且金额和数字不能认错 全部跑完以后,Ling-3.0-flash-VL 这部分的表现比预想中完整。 数学公式里的上下标和符号关系基本都能保住,小字号代码没有因为界面信息太密而丢掉大量字符;表格、发票这种更考验位置关系的图片,字段和数字之间的对应也没有被打乱。 暗光和手写反而挺有意思。 这两类图片肉眼看都没有标准文档那么舒服,但模型依然能从背景里把主要内容抽出来。不是只能认几个醒目的大字,边角的小字和局部信息也能顾到。 不过这次测下来,比较值得说的其实不是“OCR 准不准”。 传统 OCR 很容易把一张复杂页面最后变成一长串文本。字可能都认识,但标题属于哪里、公式跟着哪一段、数字对应表格哪一列,这些关系一丢,后面还得重新整理。 Ling-3.0-flash-VL 对这部分处理得更像是在“读页面”。 标题还是标题,正文跟着正文,公式和表格也能尽量保持原来的关系。原图里的视觉结构,没有在转成文字之后直接消失。 这会直接影响后面的用法。 论文截图可以继续转 Markdown / LaTeX,票据可以继续抽字段,软件截图可以拿去做知识库,成批的图片也能进一步整理成结构化数据。 图文识别本身并不是什么新鲜功能。 但如果模型能把一张人能读懂的复杂图片,尽量完整地变成机器也能继续处理的内容,那它能做的事情就比“识字”多得多了。 这也是这次用 Ling-3.0-flash-VL 做完这个小工具后,感觉最有实际价值的地方。 🔗GitHub: 🔗 Ling-3.0-flash-VL 在线体验 目前在 OpenRouter 上可免费体验: 模型:Ling-3.0-flash-VL 官方:Ant Ling
Hello AI with Jia26,341 просмотров • 1 месяц назад

用 Ling-3.1-flash,复刻了一版宝玉老师的《桃花源记》3D 网页。视频展示实际成品。 Ling-3.1-flash 是蚂蚁百灵新一代大模型,重点面向软件研发、信息检索和办公交付等长流程任务,强调从需求理解到具体成果的完整执行能力。 模型总参数约 560B,每个 Token 激活约 25B;上下文窗口上限为 1M,免费体验期间提供 256K 服务长度,可用于承载较长的文档、代码与任务历史。发布信息 本次将 Ling-3.1-flash 应用于文学场景的网页代码生成,涵盖基础页面,以及山体、屋舍、人物和桃树等场景函数。成品采用程序化三维几何构建桃林、溪流、山洞、农田与村落,支持浏览器实时交互。 网页完整保留《桃花源记》原文,以 7 幕 24 段组织“循文入境”体验,将文字、镜头和人物状态相互关联。读者可以自由观景,也可以沿原文顺序浏览,并使用暂停、回看、章节跳转和中文朗读功能。场景提供清晨、晴日、暮色与春雨四种氛围。 这份成品展示了 Ling-3.1-flash 在复杂场景代码生成中的具体应用:将文学文本与交互需求落实为可运行、可观察、可操作的网页。
Hello AI with Jia14,176 просмотров • 27 дней назад

超过20万人参加的日本大型 Cosplay 活动「StuFes 2026」,于 2026 年 5 月 17 日在大坂日本桥登场! 有些摄影师故意用超低角度拍摄,甚至刻意放大敏感部位,引发不少争议与批评。
一46,540 просмотров • 5 месяцев назад

0:33
Sensitive content
This media may contain sensitive content.


Больше нет контента для загрузки