正在加载视频...

视频加载失败

我拿一段只有9秒的企业会议视频测试了Ant Ling推出的Ling-3.0-flash-VL 视频不长场景也不复杂,但里面同时出现了人物动作、数据图表、电脑屏幕和白板文字,正好可以看看模型到底是在“看画面”,还是已经能够理解画面之间的关系 上传视频后,我没有提前告诉它会议主题,只要求它按照时间顺序描述人物、动作和环境,再判断会议类型 模型很快识别出画面中的4个人,其中1人站在双屏前讲解,另外3人坐在会议桌旁。它还区分出了操作电脑、记录笔记、指向图表等动作,人物数量和基本关系没有混在一起 让我比较意外的是,它不只看到了会议室和电脑,甚至还尝试读取了白板上的“Holbrook Creative Room 10:00am”以及“MAY、JUN、JUL、AUG”等文字。屏幕上的柱状图、折线图和右侧的山水画面也被分别识别出来,这说明模型处理的并非一张静态截图,而是在连续画面中寻找稳定出现的视觉线索 按照百灵官方公开的技术说明,模型会以固定帧率对视频进行采样。按每秒2帧计算,这段9秒视频理论上会形成约18个分析节点。模型需要在这些离散画面之间比较人物姿态、视线和手势变化,再组织成连贯描述 它判断第2秒至第4秒最适合用作宣传素材,理由是主讲人指向数据大屏,听众同时查看电脑并进行记录,“数据驱动决策”的企业形象在这一刻比较集中 不过,识别画面和理解业务仍然是两件事。模型可以判断这可能是一场业务复盘会、经营分析会或项目汇报会,但它无法确认图表展示的是营收、用户数量还是项目进度。 创意团队”跨部门协”等说法,也只能算基于环境和人员状态做出的推测,不能当成已经发生的事实 这种边界反而让测试更有价值 对于企业视频素材管理,它可以帮助工作人员快速描述画面、标记人物动作、定位适合剪辑的时间点,还能给视频建立便于检索的文字标签。但如果把它直接用于生成正式会议纪要,风险就会明显增加,因为画面不能替代发言内容,模糊图表也不能支撑具体经营结论 这次测试中,Ling-3.0-flash-VL给我的感觉他看懂了人物、环境、文字和动作关系,也给出了相对合理的场景判断,但它并没有真正掌握这场会议讨论了什么 它更像一名观察细致的视频助理,能够整理眼前的信息,却不能代替参与会议的人作出业务定性 更好的帮助了企业使用这类模型时,可以让它多做素材检索、镜头标注和初步整理,再由工作人员核对关键文字与业务结论 这是openrouter 的体验地址当前处于免费期,兄弟们可以去试试给他一个视频看他能否给出你想要的结果 Ling 3.0 Flash VL (free) - API Pricing & Benchmarks | OpenRouter Hugging Face: Ling-3.0-flash-VL 官方发布: GI/status/2095935971556782372
48,681 次观看 • 3 天前 •via X (Twitter)

30 条评论

Segun Bxx 的头像
Segun Bxx3 天前

@AntLingAGI Great breakdown of the boundary between visual indexing and actual business inference! Using it for timestamping and asset retrieval makes total sense

Em Kei 的头像
Em Kei3 天前

@AntLingAGI Important honesty: it got the people/material/action but missed that it's still an operational review meeting talking revenue. Tagging + organizing first, then verify business conclusions - solid workflow. Gonna try the free period on OpenRouter.

Em Kei 的头像
Em Kei3 天前

@AntLingAGI This is the right way to test VLMs - not just "what's in the frame" but "who is that person across frames, what are they doing, what's their relationship to the chart." Ling-3.0-Flash-VL trying to read MAY JUN JUL on whiteboard is a good signal.

Almusty 的头像
Almusty3 天前

That is the ultimate blueprint for enterprise video asset management: using VLMs for automated timestamp tagging, OCR, and shot indexing while keeping human verification for actual meeting minutes. Bypassing manual metadata entry saves countless hours. Have you experimented with scaling this up to ingest longer multi-minute corporate recordings?

meerah 的头像
meerah3 天前

@AntLingAGI 这个测试方法很专业!比单纯的物体识别难多了,同时考验了时序理解、OCR和空间关系推理。能分清4个人谁在讲、谁在记笔记,还能读出白板上的具体文字,说明Ling-3.0-flash-VL是真的在理解视频逻辑,不是只看关键帧。期待看完整版分析!

meerah 的头像
meerah3 天前

@AntLingAGI 太强了,9秒视频里有动作、图表、屏幕、白板文字,信息密度这么高都能不混乱。连“Holbrook Creative Room 10:00am”这种细节和柱状图/折线图都能分开,VL的细节捕捉能力真的进化了。

sulaiman Waleed 的头像
sulaiman Waleed3 天前

@AntLingAGI 这个测试很有说服力。Ling-3.0-flash-VL 不只是识别画面中的物体,还能把人物、动作、文字和时间顺序联系起来,这对企业视频分析确实很有价值。

sulaiman Waleed 的头像
sulaiman Waleed3 天前

@AntLingAGI 我很认同把视觉理解和业务理解分开这一点。能准确提取视频中的视觉信息,同时明确哪些只是推测,这种能力边界对实际企业应用尤其重要。 That is the best and better great job

Max.H 的头像
Max.H3 天前

@AntLingAGI 按官方说的固定帧率采样,9秒大约18个节点,模型能在这些离散画面之间比较姿态和手势变化,再拼成连贯描述,这个机制解释得挺清楚。问题是:如果主讲人只在某一两帧指向大屏,采样刚好错过,推荐的“2-4秒宣传素材”会不会就立不住?

TravisnotScott 的头像
TravisnotScott3 天前

@AntLingAGI The distinction between visual recognition and actual business understanding is especially important. Good asset analysis doesn’t automatically mean reliable meeting interpretation

Vicky Silas 的头像
Vicky Silas3 天前

@AntLingAGI Charts, tables, text, and UI together make a much harder vision test.

Almusty 的头像
Almusty3 天前

Tracking dynamic interactions across discrete frames—from whiteboard text and UI charts to synchronized presenter gestures—proves how effectively native multimodal models handle continuous temporal data. Did you test how adjusting the frame sampling rate impacts accuracy when tracking faster, more complex movements?

Daniel Chen 的头像
Daniel Chen3 天前

9 秒会议视频,2fps 采样 18 帧。他自己把采样率写进去了,但没意识到那是天花板:短于 500ms 的动作对模型根本不存在,所以"理解画面关系"的上限是被采样率卡的,不是被模型卡的。我的评论就问这个——如果它描述出了需要帧间才能看到的东西,那是补全不是看见。

web3丨劳斯莱斯&剑豪 的头像
web3丨劳斯莱斯&剑豪3 天前

@AntLingAGI 我去给他一个视频试试

西西🎒 的头像
西西🎒3 天前

@AntLingAGI 这是这是真的能省时间

鱼哥 的头像
鱼哥3 天前

@AntLingAGI 竟然可以免费用Ling-3.0-flash-VL,这个真不错

陶朱 | Gate Card刷遍全球 | XT 8周年 - Build the NeXT🎉 的头像
陶朱 | Gate Card刷遍全球 | XT 8周年 - Build the NeXT🎉3 天前

@AntLingAGI 这模型看画面挺清楚的

神樂Freyr 的头像
神樂Freyr3 天前

@AntLingAGI 这个确实实用啊

Charlez | 💻 Builder 的头像
Charlez | 💻 Builder3 天前

@AntLingAGI Nice read

甬哥侃侃侃ygkkk 的头像
甬哥侃侃侃ygkkk3 天前

@AntLingAGI 视频内容识别非常优秀吗?我觉得还行吧,一般AI能办到的,Ling-3.0-flash-VL也能办到,总体来说中规中矩。

Synapse 的头像
Synapse3 天前

@AntLingAGI What makes this stand out is the honesty of showing both versions. The first was “like but not quite right.” The second with the visual feedback loop is clearly tighter and more polished.

IBNU ABDULHAKEEM 📿☪️ 📊 的头像
IBNU ABDULHAKEEM 📿☪️ 📊3 天前

Sampling at 2 FPS to extract 18 discrete visual nodes is a great test for temporal consistency. What makes models like Ling-3.0-flash-VL effective here is the Video RoPE tracking, which binds spatial elements across time so the presenter's gestures and board text stay linked instead of being treated as isolated stills.

ProvenDaily🔶BNB 的头像
ProvenDaily🔶BNB3 天前

@AntLingAGI 9秒视频还能拆出这么多帧 挺好奇它认白板文字稳不稳

Thienco71 | 🚢 的头像
Thienco71 | 🚢3 天前

@abdulhakeemson0 @AntLingAGI same kind of thing, payout preview on @arctionapp updates while you decide. you know what up and down pay before you commit

Ape Be 的头像
Ape Be3 天前

@abdulhakeemson0 @AntLingAGI since we are on the topic, the @arctionapp wheel resets daily. miss a day and you feel it

Crypto 阿飞 的头像
Crypto 阿飞3 天前

@AntLingAGI 来了老师

Jask 的头像
Jask3 天前

@AntLingAGI 又出现一个视频理解模型,不知道有没有豆包强🤣

Miya | Gate Card刷遍全球 的头像
Miya | Gate Card刷遍全球3 天前

@AntLingAGI 大模型可以的呀!

Equinox 的头像
Equinox3 天前

@AntLingAGI The step-by-step with the five images makes the whole process easy to follow. From original screenshot to first render to marked errors to improved second version — that progression is very helpful.

拳头👊🕊️ 的头像
拳头👊🕊️3 天前

@AntLingAGI 连白板上的会议名和时间都读出来了,这点比我试过的强

相关视频

绝了!这应该是最适合接入视频剪辑工作流的AI!! 因为它真正能看懂视频,并且够快够便宜! 对于做视频,不管是专业还是非专业选手,最耗费时间的其实就是找素材,和选素材! 好几个小时的素材,可能真正能用上的就几分钟! 而为了找到合适的,往往需要把每一条都从头看完, 根据脚本反复拖动时间轴、记录和剪切可用的素材。 这非常费时间,一点也不AI。 我也试过用很多AI来解决这个需求,包括一些所谓的视频素材AI管理工具, 能读视频的多模态模型其实很多,靠截图的方式能够理解视频的内容, 但也仅限于知道视频的内容,因为这些模型不太能理解视频里各个镜头和画面的时间关系。 这次看到 Ant Ling 新出的多模态模型 Ling-3.0-flash-VL, MoE架构,总参数124B、有效激活5.5B参数,支持256K长上下文和VideoRoPE时空编码。 激活参数更小,说明成本更低! 这个VideoRoPE时空编码,据说是靶向解决我上面说的那个问题! 第一时间测试了一下!! 我丢给它一个演讲的视频,让它告诉我讲了什么,有什么重点, 另外我告诉它,我想基于这个演讲视频剪辑一个高光短视频,需要它帮我找到一些高光时刻,然后告诉我准确的时间码,并且为这个高光短视频写一个文案。 这已经不是单纯的“视频总结”之类的简单任务, 它需要按照时间线给出: 高光时间段+核心观点+入选理由+建议标题+开头钩子+发布文案。 这应该才是多模态模型能够发挥价值的地方!! 普通模型可以告诉你“一小时的视频讲了什么”,但内容创作真正需要的是:这一小时里,到底哪些能够用,要怎么用? 让我比较惊喜的是,它不光给了我高光视频剪辑要用的分镜、脚本、文案,甚至还给了我转场、和BGM的建议! 完全就是一份可以照做的剪辑执行单!! 这说明和它对原视频的理解已经远超我的预估!! 我在想,也许可以把这套能力接入剪辑工具,整个工作流就还可以继续延伸: 读取视频 → 理解内容 → 定位高光 → 输出时间码 → 调用工具裁剪 → 生成标题和发布文案。 完全实现视频剪辑自动化!! 当然,理想是丰满的,AI挑出的素材不一定全都符合审美和叙事偏好, 时间码和上下文完整性也需要人工复核。 要想创作出好的视频作品,必然还是需要人的参与! 不过,用AI搞定素材的初筛,也是目前的超级刚需啊!!

沐阳

11,459 次观看 • 11 天前

无敌了,我用 30 分钟,做了个给小孩订正作业的小工具。 现在这种视觉模型,已经开始够快、够便宜,可以直接拿来干活了。 我把孩子做完的作业丢给蚂蚁百灵刚开源的 Ling-3.0-flash-VL。 我没让它直接处理图片,我让它先让它看整张作业,把错题、题目区域、手写答案的位置直接输出成坐标。 后面的程序拿着这些坐标去裁图、去手写,再整理成可以重新订正的题。 这就比单纯 OCR 有意思多了。 🔥当然,现在还远没到“干死作业 App”。 它坐标可能有偏差。 但以前这种东西,你得自己接 OCR、版面分析、错题识别,甚至训练专用模型。 现在一个通用视觉模型,30 分钟就能先把整条链路跑通。 这里也有个很容易误解的地方: 视觉模型,不等于出图模型。 Ling 这种 VLM 的视觉,是它能看图片、截图、文档、视频。 它本身不是 Image 2.5 那种负责生成像素的模型。 它擅长看懂以后,把结果变成文字、坐标、代码或者动作,然后继续干活。 Ling-3.0-flash-VL 总参数 124B,但 MoE 每 token 只激活约 5.5B。 这对 Visual Agent 很重要,极为广阔的知识,以及极低的激活,能做到又快又好。 🔥再往前一步,这种模型甚至很适合当教师模型。 先让 Ling-3.0-flash-VL 批量看作业,生成错题框、手写区域、版面结构这些坐标和标注,再用这些数据训练一个更小、更快的专用模型。 先让大模型直接干活,再让大模型教小模型干活。 这个 Demo已经完全跑通了,30 分钟能做到这一步,已经无敌了。 OpenRouter现在可以免费使用Ling-3.0-flash-VL:

实践哥 Li

83,455 次观看 • 5 天前

Ling-3.0-flash :一个更适合实际工作的 AI 执行助手 过去一段时间,大模型的发展重点一直集中在能力提升上。模型能回答什么问题、能处理多复杂的任务,成为行业关注的焦点。但随着 AI 开始进入真实工作流程,用户对于模型的期待也在发生变化:除了能够提供高质量答案,更希望它能够稳定、高效地完成具体任务。 在日常工作中,真正消耗时间的往往不是复杂问题,而是大量重复性的处理工作。例如整理资料、分析数据、生成文档、处理代码、执行流程任务。这些事情需要投入大量精力,但其中有很多环节都可以通过 AI 进行优化。 Ling-3.0-flash 的定位正是在这一方向展开。它并不是单纯追求更大的模型规模,而是聚焦 Agent 工作流中的执行效率,帮助用户将明确的任务快速推进完成。官方介绍,该模型面向长程 Agent 工作流设计,重点提升响应速度、工具调用能力以及任务执行稳定性。 从实际体验来看,它最大的特点是能够很好地融入已有工作流程,让 AI 从一个问答工具变成一个真正参与任务执行的助手。 实测一:资料整理效率明显提升 第一个测试场景是长文档处理。 在实际工作中,经常会遇到需要快速阅读大量资料的情况,例如行业报告、会议记录、产品文档等。如果完全依靠人工整理,需要花费大量时间筛选重点、提取信息,再重新组织内容。 测试过程中,我将一批较长的资料交给 Ling-3.0-flash 处理,让它完成信息提取、重点归纳和结构化整理。 整个过程比较符合实际工作习惯。它能够快速抓取文档中的核心内容,并按照任务要求整理成更加清晰的结构。尤其是在面对大量相似信息时,它可以帮助用户减少重复阅读和手动整理的时间。 这类能力对于内容运营、产品分析、市场研究等岗位非常实用。很多时候,用户并不是需要 AI 替自己完成最终判断,而是希望它先完成信息整理,把大量基础工作处理好,让人可以把精力放在更重要的分析和决策上。 实测二:代码协作更加高效 第二个体验场景是代码辅助。 AI 编程已经成为大模型应用的重要方向,但真正影响开发效率的,不只是生成代码的速度,更重要的是能否持续参与开发过程。 在测试中,我让 Ling-3.0-flash 协助完成一个简单工具开发任务,包括生成基础代码、调整功能逻辑以及根据反馈进行优化。 我需要做一个AI 会议纪要整理助手,请帮我生成代码,把会议录音转文字或会议记录,自动生成:会议摘要、决策事项、待办任务、负责人、截止时间 首字耗时:337ms·完成耗时:68984ms·每秒 token 数:371 ,Ling-3.0-flash生成的会议纪要整理助手功能完整、专业美观,支持录音转文字、AI自动生成摘要/决策/待办任务,并支持导出和多种交互功能。 实际体验下来,它更适合成为开发过程中的协作助手。开发者可以先确定整体需求和功能方向,再让 AI 快速完成代码生成、修改和补充。这样一来,开发者不需要把大量时间花在重复编码和基础调整上,而可以更多关注产品逻辑和技术方案。 这种协作方式更接近真实开发场景。人负责判断方向,AI 负责提高执行效率。 实测三:批量任务处理展现执行优势 除了开发场景,批量信息处理也是 Ling-3.0-flash 比较适合的方向。 例如整理用户反馈、分析业务数据、处理文本分类等任务,通常具有数据量大、格式相对固定的特点。 在测试中,我模拟了用户反馈整理场景,让模型对大量文本进行分类,并提炼其中的主要问题。 从结果来看,它能够快速完成信息归类,并输出较为清晰的结构化结果。 这类任务的价值在于帮助用户减少大量机械操作。以前需要人工逐条查看和整理的信息,现在可以先由 AI 完成初步处理,再由人工进行确认和优化。 对于企业团队来说,这种能力可以应用在客服分析、市场调研、内部知识整理等多个环节。 速度和效率,是 Flash 模型的重要优势 随着 AI 应用逐渐深入业务流程,模型的效率同样成为重要指标。 很多实际任务并不需要每一次都进行复杂推理,而更需要快速响应和稳定执行。例如信息分类、内容整理、数据转换等工作,如果能够以更高效率完成,就能明显提升整体生产力。 Ling-3.0-flash 支持混合思考模式,可以根据任务复杂程度调整处理方式,在响应速度和任务能力之间进行平衡。 这种设计让它更适合高频使用场景。用户可以将更多日常任务交给 AI 处理,而不必担心流程效率受到影响。 从使用体验来看,它更像一个高效执行伙伴 经过几个场景测试后,Ling-3.0-flash 给我的整体感受是,它并不是单纯提升聊天体验,而是在帮助用户重新分配工作时间。 它可以处理大量信息整理工作,可以辅助开发过程,也可以参与自动化任务执行。 对于普通用户来说,它能够减少重复操作,提高工作效率。 对于开发者来说,它能够加快开发流程,降低基础工作的时间成本。 对于企业来说,它能够帮助更多业务流程实现自动化。 未来 AI 的价值,不只是回答问题,而是逐渐参与到真实工作流程中,帮助人完成更多具体任务。 Ling-3.0-flash 所体现的方向,就是让 AI 从一个提供答案的工具,进一步成为一个能够执行任务、提升效率的工作伙伴。 官推: 感兴趣可以自己试试 👉

冰糖雪梨

15,661 次观看 • 1 个月前

让 AI 帮我判断,哪个镜头值得留下 我让 AI 看了一段自己做的《五王醉归》。它给我的一个剪辑建议是:留住桌下的杯盏镜头。 这倒是切中了我做片子时经常纠结的问题:画面都挺好看,但剪短的时候,到底该留哪一段? 这次拿 Ling-3.0-flash-VL 当了一回剪辑助理。我上传了15秒的宴席片段,没给完整剧情,只让它看画面:梳理人物动作、挑保留段落,再说清楚为什么。 它把这段拆成了举杯、桌下杯盏、多人扶持几个环节,还特意提醒:如果跳过杯盏这一段,转折就少了视觉证据。 我回看片子,这个建议确实有用。杯盏不只是一个道具特写,它把前面的共饮,和后面人物状态的变化接了起来。 另一个我喜欢的地方,是这次回答把“看到什么”和“可能意味着什么”分开了。看到有人被扶住,没有直接把原因写死。 对我来说,这种视觉理解接进创作流程,最有意思的不是让 AI 替我做导演,而是多一个能拿着画面跟我讨论取舍的助手。 先帮我整理出值得回看的位置,再由我核对时间点、决定怎么剪。这个用法,我会继续试。 想自己试试的,可以去 OpenRouter 体验 Ling-3.0-flash-VL,目前处于免费体验期。免费额度和开放情况以平台页面实时信息为准。 体验地址: 合作内容|视频素材为本人 AI 创作;附真实测试录屏。

波妞PONYO

23,455 次观看 • 4 天前

用 Ling-3.0-flash-VL 做了个图文识别小工具。 功能很简单:图片丢进去,直接识别里面的文字、数字、公式,同时尽可能保留原来的排版和内容关系。 为了看看它处理复杂图片到底怎么样,测试素材故意选得杂了一点: • 数学论文:正文、公式、上下标、希腊字母混排 • IDE:小字号代码、Terminal 输出、各种符号 • 图表:表格、数字、文字挤在一起 • 暗光菜单:低对比度、中英文混排 • 手写笔记:字形不标准、排版随意 • 发票:字段密集,而且金额和数字不能认错 全部跑完以后,Ling-3.0-flash-VL 这部分的表现比预想中完整。 数学公式里的上下标和符号关系基本都能保住,小字号代码没有因为界面信息太密而丢掉大量字符;表格、发票这种更考验位置关系的图片,字段和数字之间的对应也没有被打乱。 暗光和手写反而挺有意思。 这两类图片肉眼看都没有标准文档那么舒服,但模型依然能从背景里把主要内容抽出来。不是只能认几个醒目的大字,边角的小字和局部信息也能顾到。 不过这次测下来,比较值得说的其实不是“OCR 准不准”。 传统 OCR 很容易把一张复杂页面最后变成一长串文本。字可能都认识,但标题属于哪里、公式跟着哪一段、数字对应表格哪一列,这些关系一丢,后面还得重新整理。 Ling-3.0-flash-VL 对这部分处理得更像是在“读页面”。 标题还是标题,正文跟着正文,公式和表格也能尽量保持原来的关系。原图里的视觉结构,没有在转成文字之后直接消失。 这会直接影响后面的用法。 论文截图可以继续转 Markdown / LaTeX,票据可以继续抽字段,软件截图可以拿去做知识库,成批的图片也能进一步整理成结构化数据。 图文识别本身并不是什么新鲜功能。 但如果模型能把一张人能读懂的复杂图片,尽量完整地变成机器也能继续处理的内容,那它能做的事情就比“识字”多得多了。 这也是这次用 Ling-3.0-flash-VL 做完这个小工具后,感觉最有实际价值的地方。 🔗GitHub: 🔗 Ling-3.0-flash-VL 在线体验 目前在 OpenRouter 上可免费体验: 模型:Ling-3.0-flash-VL 官方:Ant Ling

Hello AI with Jia

22,106 次观看 • 4 天前

蚂蚁百灵刚刚发布了 Ling-3.0-flash: 一个AI 执行层的关键拼图 刚刚看到 Ling-3.0-flash 正式发布,我觉得这款模型值得认真关注。原因很简单:在 AI 工程越来越深入到实际业务的今天,大家早就不满足于模型“会不会想”了,更关键的是它“能不能持续做”。 尤其是在 Agent 工作流中,需要高频调用工具、迭代代码、处理长程任务时,一个响应快、执行稳的执行引擎成了刚需。Ling-3.0-flash 的出现,正好瞄准了这个缺口。 1. Agent 的执行层 从我的角度看,它最聪明的一点是没有去硬拼超大模型的深度推理能力,而是把自己定位成一个高速执行引擎——负责把已经规划好的任务快速落地。 这在实际应用中特别实用,比如当大模型把方案设计好之后,剩下的代码生成、工具调用、批量处理就需要一个既快又稳的模型来接手。 2. 为什么它能兼顾速度和成本 技术细节上,它采用 124B 参数的 MoE 架构,但实际激活参数约 5.1B,在推理速度和运行成本之间找平衡。 它还支持混合推理模式:简单任务可以关闭 Reasoning,降低延迟,适合大批量处理;复杂任务则可以开启思考模式,保持逻辑连贯。 原生支持 256K 上下文,对需要持续读取历史指令和项目状态的 Agent 工作流也很重要。 3.如何使用 我觉得 Ling-3.0-flash 最适合做 Agent 工作流里的执行节点。反复调用 API 或 MCP 工具时,它能根据结构化错误信息自我诊断和修复,不容易在循环调试中卡死,因此适合放进 Loop 或 Graph 架构。 4.结对编程和批量任务 结对编程是一个典型场景:人负责架构规划、边界定义和测试,Ling-3.0-flash 负责快速生成代码、调用工具、读取报错,并根据反馈持续修改。 批量处理长文档、日志、简历和结构化数据时,它看重的也是速度、格式稳定性和成本控制。直播数字人或高频办公协作,则需要它的低延迟响应来减少体验断层。 5.边界 当然,它不是万能模型。复杂系统不能只靠一句指令搞定;缺乏架构和测试环境时,结果可能跑偏;需要深度冷门知识的研究任务,还是更适合交给更大规模的推理模型。 更合理的用法是:大模型负责搜索、规划和架构设计,把方案写成规范文档;Ling-3.0-flash 负责高频工具调用、代码执行和批量处理。 总结:Ling-3.0-flash 不是来替代所有模型的,而是把 Agent 工作流里“执行层”这件事做得更快、更稳。大模型负责想清楚,它负责做出来。

奶牛叔

66,157 次观看 • 1 个月前

卧槽,Hypit 这次确实有点意思。 把它接进 Codex,丢一条参考视频过去,再说一句“帮我 Clone”,它就能把原片拆成可编辑的视频工程。 人物能换、服装能换、色卡能换。 原片的构图、镜头节奏、字幕、转场和画面层级,会尽量保留下来。 我这次用 Codex 跑了 Hypit,复刻了两条短视频。 一个是「豆包帮我清理桌面」的场景创意 yanhua,一个是 @陶阿狗君 的旅行变装。 它先把视频拆成一个可编辑的 workflow。 谁在说话、哪一段用什么图、字幕怎么排、画面怎么动,都变成工程里的零件。 流程很简单: 1、给 Codex 装上 Hypit Skill npx skills add hypit-ai/hypit -g 2、配好视频模型 API 我这里用即梦 CLI 调 Seedance,先确认模型能正常出片。 3、把参考视频和人物图交给 Codex 告诉它保留原片构图和分镜节奏,把人物换成参考图角色,再生成新的色卡和服装。 4、先确认图片,再生成动态镜头 图片、视频和声音可以分阶段处理。图片不满意先改,确认后再调视频模型出片。 我觉得 Hypit 最有意思的地方,是它把视频制作从一次性「抽卡」,变成可以持续修改的项目。 你能一边预览成片,一边看对应素材和源码。想换人、改字、调镜头节奏,都有地方下手。 工具是开源的,模型和 API 费用各自另算。 想用 AI Agent 做视频 Clone 的,可以自己装了试试,效果因模型和参考片差异会比较大。 官方仓库(开源):

行者AI视频

134,455 次观看 • 2 天前

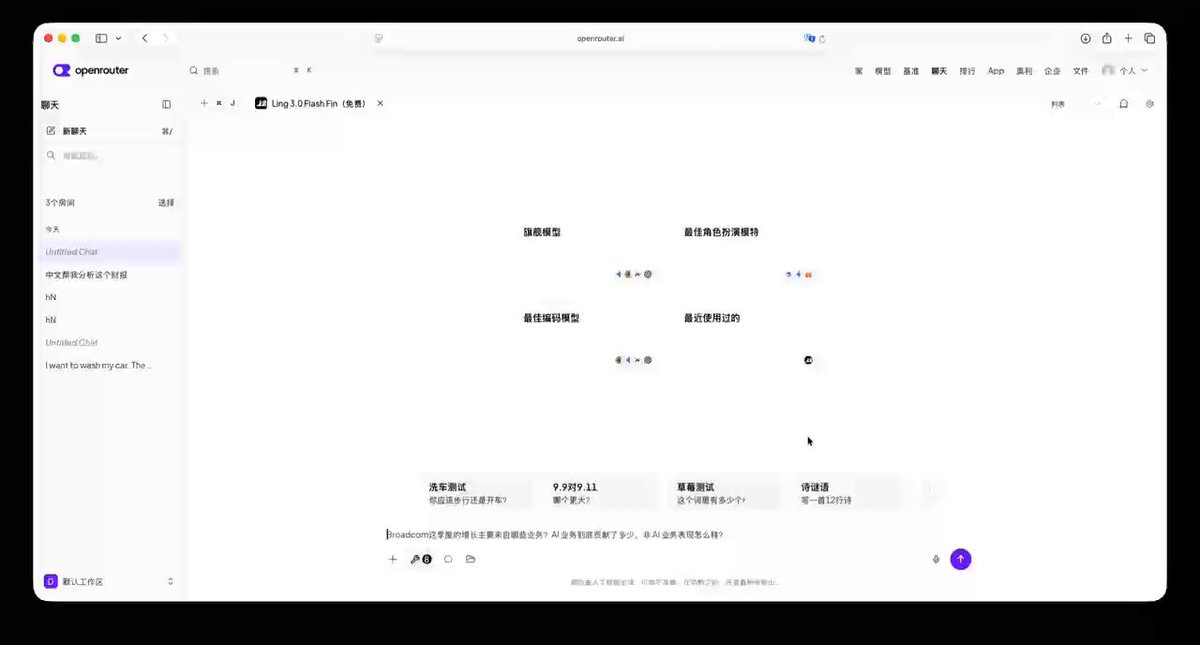
最近在看 Broadcom,所以最新财报出来后,我直接拿来测了下 Ling-3.0-flash-Fin。 我比较想知道的是:AI 业务涨得这么快,Broadcom 现在的增长到底有多依赖 AI? 这次没有让模型简单总结财报,而是让它顺着半导体、AI 收入、软件业务、利润和现金流一路拆下去,同时核对数据来源和口径。 最后给出的判断比较清楚: Broadcom 这季度增长很强,AI 已经成了最明显的驱动力,现金流表现也不错。 但隐患也很明显——如果后面的增长越来越集中在 AI 加速器和网络需求上,那就要继续看这种高强度需求到底能维持多久。 这也是 Ling-3.0-flash-Fin 比较有意思的地方。 它不是只回答一个金融问题,而是会把检索、分析、计算和结果整理串起来,最后给出可以复核的结论和风险提示。 它基于 Ling-3.0-flash 继续做金融增强,依旧是 124B 总参数、5.1B 激活参数。 这次比较让我意外的是,它对财务数据之间关系的处理,明显更像在真正做研究:不会看到一个高增长数字就停下来,而是会继续追收入结构、利润、现金流和潜在风险。 至少从这次 Broadcom 财报测试来看,它的金融增强,不只是“更懂几个金融术语”。 Ling-3.0-flash-Fin 试试,大家现在可以直接在 OpenRouter 上体验: 开源地址: 以上仅为模型测试,不构成任何投资建议。

Hello AI with Jia

33,298 次观看 • 8 天前

以前在 360 工作过,也一直持有一点 360 的股票。 所以看到最新一季报后,我还是挺想认真研究一下:这次扭亏,到底是业务变好了,还是费用降下来了? 刚好最近在体验 Ling-3.0-flash-Fin,就把整份财报直接丢给它做了次测试。 它不只是把财报摘要了一遍,而是顺着营收、毛利率、销售费用、研发费用和经营现金流一路拆下来,把数据来源和计算过程也列得比较清楚。 这也是 Ling-3.0-flash-Fin 比较打动我的地方:它不是只 针对某一道金融问答给出答案,而是把信息检索、研究推 理、计算和结果交付串成一条完整的工作流。面对财报、 工作簿和多份研究材料,它会尽量优先寻找可信的一手信 息,核对数据口径,再调用工具完成计算,让结论能够回 到原始材料中复核。 它延续了 Ling-3.0-flash 的长上下文能力,在金融语料 训练和工具使用上做了专门增强,同时采用 124B 总参 数、5.1B 激活参数的架构,兼顾专业能力和运行效率。 再加上开放模型路线,对金融机构、研究团队和开发者来 说,也更方便进一步部署和二次开发。 最后的判断是:360 一季度确实扭亏了,但利润改善更 多来自费用下降;收入和现金流也在改善,不过现在还不 能太早下结论。 因为我既是前员工,又是股东,看这家公司多少会带点感 情色彩。让模型帮我把数据重新梳理一遍,反而能提醒自 己:熟悉一家公司,不等于真的看懂了它的财报。 分析结论十分透彻 还带有隐患提示 大家也可以找一家自己熟悉的公司,把财报扔给 Ling- 3.0-flash-Fin 试试。现在可以直接在 OpenRouter 上体验: 看看它给出的结论,和你的判断是不是一样。 以上只是模型测试,不构成任何投资建议。

程序员端哥

24,081 次观看 • 20 天前

这两天看到我一直很喜欢的设计师阿哲 阿哲Phil 的个人网站,我挺喜欢他个人主页的那个风格。 看着看着突然冒出一个念头: 这种个人审美很强的网站,模型光看录屏,能不能做出来? 于是我顺手录了 10 秒左右,从页面上划过去,直接把视频丢给 Ling-3.0-flash-VL,让它照着做一版。 没给源码,也没拆页面,更没写一大段提示词。输入就那段录屏,加上一句很简单的需求。其实扔进去的时候,我没抱多大期待。视频一晃就过去了,有些细节让我自己暂停看,也未必记得住。 Ling-3.0-flash-VL 是百灵在 Ling-3.0-flash 上加了视觉理解和 visual agent 的版本。官方提到的能力挺多,视觉感知、STEM、文档、前端编码、医疗报告都在里面。我这次没全测,就看一件事:它能不能看完一段网站录屏,真把页面做出来。 结果打开以后,我确实愣了一下。 按肉眼看,和阿哲的原版大概有七成像。大的版式、配色和页面感觉都抓到了,生成出来的也不只是一个摆着看的空壳。按钮能点,交互能跑,放进浏览器里,已经像个可以接着改的半成品。 当然,剩下那三成也挺明显。风格不够细腻,字体没那么贴,交互还是有点僵,一些细节只学到了大概。把两个页面并排放在一起,差距还是能看出来。要我直接拿去上线,我肯定不会;拿它当第一版,我觉得够了。 以前脑子里有个页面的样子,最麻烦的是说不清。你跟开发说想要“有点设计感”“交互顺一点”,讲了半天,对方可能还是不知道你想要什么。自己不会写代码的话,很多想法就一直停在收藏夹里。 现在简单多了。先找一个接近自己想法的网站,录一小段,让模型搭出来。哪里不对,直接看着页面改。它没有把阿哲的网站原样搬过来,但它把一张白纸直接做到了七成。 所以这次测完,我还挺愿意安利 Ling-3.0-flash-VL。离专业前端当然还有距离,但对没代码基础、想做个人网站或者产品 Demo 的人来说,先把第一版弄出来,已经能省不少事了。 感兴趣的都可以去试一试:

阿川 | AI thinking

33,284 次观看 • 7 天前