Loading video...

Video Failed to Load

Go Home

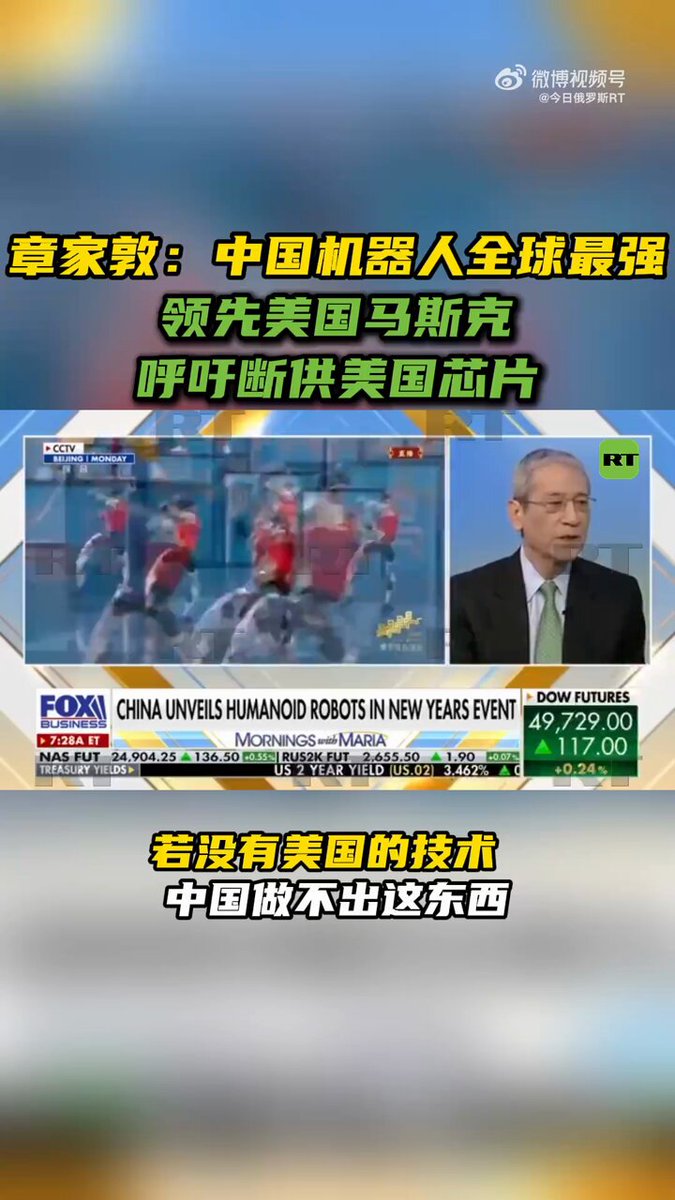
春晚宇樹機器人表演騙局曝光!全網炸鍋! 昨天,春晚上大出風頭的宇樹智能機器人“現象級破圈”,視頻在國外瘋傳,老外評論區爆炸了。 今天醜聞被揭開,原來台上每台機器人後面都有一個真人在搖控,類似中國的皮影戲。 《藍鯨新聞》之前曝光過機器人行業的”皮影戲”——號稱自主運行的機器人,背後是操作員遠程操控。 還有團隊拿廉價鋁型材拼個機械臂,寫個固定程序,就敢說全自主分揀機器人,真是一代人有一代人的騙局。

37,077 views • 7 months ago •via X (Twitter)

21 Comments

熊維尼's profile picture
熊維尼7 months ago

承認他人的成就很難嗎?就算有人在背後遙控,你要做出這種動作都非常的困難!

光鸣区块's profile picture
光鸣区块7 months ago

國家給了很好的政策,這邊資本就騙國家

ENERGY19's profile picture
ENERGY197 months ago

请大家帮我找找我孙子,我孙子见了国产机器人逢人就说“遥控”的,过年了,我这孙子脑子患过疾认不得回家的路,请大家多转发,谢谢了。

林山寨村长's profile picture
林山寨村长7 months ago

去年脑血栓,今年后空翻。

D.Shen's profile picture
D.Shen7 months ago

傻逼才玩这种智障玩具,丢人现眼❗

王桦桦's profile picture
王桦桦7 months ago

假、人扮🖕🖕🖕

哪有名字's profile picture
哪有名字7 months ago

所谓海外高华和台蛙这么自卑吗?承认中国强这么难吗?

刘一飞's profile picture
刘一飞7 months ago

只有傻子才信……这个土壤只能生出这些玩意

无论's profile picture
无论7 months ago

台湾的弱智这两天疯狂展示智商的下限🥴🥴🥴🥴🥴

chinar's profile picture
chinar7 months ago

移花接木做得挺溜,希望外国政府的人都相信,这样你就立大功了

Paulie Heygate's profile picture
Paulie Heygate28 days ago

其实,大大方方地公开做遥控,也是很有市场的;可惜就是好“装”,装成自己不是的东西

He🇨🇳🕊️'s profile picture
He🇨🇳🕊️7 months ago

遥控就遥控吧,穿上防弹衣,就问你怕不怕

Canal logic🇺🇦🇨🇦's profile picture
Canal logic🇺🇦🇨🇦7 months ago

你得有多蠢啊

tang lin(关注我 破谣言)'s profile picture
tang lin(关注我 破谣言)7 months ago

中国机器人的发展让很多人眼红嫉妒了。开始造谣说春晚机器人背后有人员遥控 1、造谣账号放出的视频里技术人员穿着短袖,根本不是现在北京的寒冷季节2、美国机器人早期也需要遥控3、假设春晚机器人后面有人员遥控,那么十几个人要控制那么多按钮还要保持复杂动作一致性、神同步。请问哪个团队能做到?

Jims's profile picture
Jims7 months ago

🐸的智商上限就你这样了,回去面壁吧🤣

level25's profile picture
level257 months ago

你这帖开得好啊,现在西方国家都在害怕中国机器人拿枪杀进战场,你赶紧的,把你的贴发给那些西方国家的人看看,让他们知道中国的机器人只会跳舞不能投入战争,这样西方国家也不会那么针对中国,谢谢你啊

Leo Chen's profile picture
Leo Chen7 months ago

遙控有不簡單. 我比較懷疑是AI製片, 因為沒有現場觀眾.

EdwLee's profile picture
EdwLee7 months ago

哎呀又献丑啦哈哈

🇨🇳电子宠物在哪里's profile picture
🇨🇳电子宠物在哪里7 months ago

都安上导弹,遥控起来更精准,也不耽误命中你

limeimei's profile picture
limeimei7 months ago

在美国活得跟sb似的,地位都没黑人高

BinBin Z's profile picture
BinBin Z7 months ago

民進黨這些年的執政,一點進步都没有。 做不出機器人,做不成無人機,AI項目為0,台灣要被民進黨敗光了。連遙控的標的物都没有,哪來的資格嘲笑?

Related Videos

這是我第一次聽到 Jim Fan 的演講,非常幽默有趣,然後我覺得有生之年大概買一台人形機器在家處理家事、幫你洗頭髮大概穩了,好好活著,各位。 在 AI 領域,我們常聽說圖靈測試(Turing Test)是衡量機器能否展現與人類無異對話能力的里程碑。如今,大型語言模型(LLM)似乎已悄悄地通過了這個測試,但大家對其突破已習以為常,甚至會因為語音助理慢了幾秒或程式碼沒被完全除錯而抱怨連連。 NVIDIA AI 研究總監、身為廣受矚目人形機器人專家 Jim Fan 指出,當前業界對 LLM 的驚人進步視為「只是又一個平常的星期二」(just yet another Tuesday),這反映了我們對文字世界 AI 的標準已大幅提高。 然而,當我們將目光轉向現實世界,讓機器人進行物理操作時,會發現挑戰巨大得多。 Jim Fan 在演講中提出了一個引人深思的概念:「物理圖靈測試 (Physical Turing Test)」。這個測試的想像情境是:如果你回家後,看到雜亂的房間被整理得乾淨俐落,甚至還準備了一頓浪漫的燭光晚餐,而你無法分辨這是由真人還是機器人完成的,那代表這個機器人通過了物理圖靈測試。 但現實呢?看看那些連站起來都困難的人形機器人,或是嘗試為主人做早餐卻搞得一團亂的機器手臂(雖然辨識出牛奶值得給 A-,但湯匙餵食的確是 VIP 等級的體驗),我們離「物理圖靈測試」還差得很遠。 實體 AI 的最大瓶頸:資料飢渴症 為什麼物理圖靈測試如此困難? Jim Fan 點出了核心問題:資料。LLM 研究人員抱怨網際網路資料快被用完,稱其為 AI 的「化石燃料」。但對機器人學家來說,我們甚至連這種「化石燃料」都沒有。真實世界的機器人資料——例如關節的精確控制訊號、連續的運動軌跡——是無法從網路上抓取的。這些資料必須透過昂貴且耗時的「遙控操作」(teleoperation)方式收集,也就是由真人穿戴感應裝置來遠端控制機器人,手把手地教它完成任務(例如從烤麵包機拿出麵包再淋上蜂蜜)。 這種方式極度沒效率,Jim Fan 將其比喻為燃燒「人類燃料」(human fuel),比化石燃料還稀缺,每天每個機器人頂多運作 24 小時,而且真人會累,機器人更容易壞。這嚴重限制了機器人學習的多樣性和規模,形成了一個巨大的資料瓶頸。 模擬世界的核能:突破資料荒的救星 要突破這個瓶頸,唯一的出路是「模擬 (Simulation)」,找到機器人學的「核能」。Jim Fan 介紹了NVIDIA為此推進的三階段模擬策略: 模擬 1.0:數位分身 (Digital Twin) 概念:在虛擬世界中建立機器人和環境的一對一精確拷貝。 方法:利用高效能的向量化物理引擎,可以在單一 GPU 上模擬上萬個環境,速度比現實世界快上萬倍。結合「領域隨機化 (Domain Randomization)」技術,在模擬時隨機改變重力、摩擦力、物體重量等參數,迫使 AI 在各種條件下都能執行任務。 優勢:極快的訓練速度。訓練出的模型可以直接零次轉移 (zero-shot) 到真實世界機器人上,無需微調。例如,訓練機械手在模擬中轉筆,訓練機器狗在球上平衡,訓練人形機器人行走(10 年訓練量在 2 小時模擬完成)。一個僅有 150 萬參數的神經網路就足以捕捉人形機器人全身平衡和敏捷動作的複雜控制。 限制:數位分身需要人工精確建模,建立複雜環境耗時費力,模擬的多樣性仍然受限於人工設定的範圍。 模擬 2.0:數位表親 (Digital Cousin) 概念:開始在模擬中引入生成式 AI。雖然不像數位分身那樣是精確拷貝,但能產生足夠多樣的環境和場景,「像數位分身的表親」。 方法:利用 3D 生成模型生成場景中的各種物品(如家具),使用擴散模型(Diffusion Model)生成紋理貼圖,利用 LLM 根據文字提示生成場景佈局的 XML 檔案。 NVIDIA 的 Robocasa 框架就是例子,可以生成大規模、包含日常任務的模擬場景,除了機器人本身,其他幾乎都是生成的。 優勢:顯著增加了環境和任務的多樣性。可以在模擬中進行遙控操作,然後將軌跡變異、擴展到更多生成的環境中,實現 N (環境數) * N (動作變異數) 的資料乘法爆炸。雖然畫面真實度可能不及真實世界,但「足夠接近」。 限制:相較於 1.0,運行速度可能較慢,仍部分依賴傳統渲染管線。 模擬 3.0 (世界模型 / 擴散模型):數位遊牧者 (Digital Nomad) 概念:直接利用生成式模型(特別是影片擴散模型)來模擬物理世界的互動,擺脫對傳統物理引擎的依賴。 方法:以大量真實世界影片(數百萬段網路影片)訓練影片擴散模型,使其學會模擬各種複雜的物理現象(如流體、軟體變形)。 NVIDIA 的研究表明,只需用真實機器人實驗室收集的少量領域特定資料微調通用的影片生成模型,就能讓模型學會模擬機器人的精確互動。 優勢:極致的多樣性。影片擴散模型能模擬任何它在訓練資料中「看過」或「想像」的互動,不受傳統物理引擎的限制(例如模擬機器人彈烏克麗麗,即便硬體不支援,模型也能「畫」出來)。 這就像讓機器人漫遊在影片模型的「夢境空間」(dream space)——一個壓縮了海量網路影片的多元宇宙,實現「萬物、處處、一時」(Everything Everywhere All at Once) 的互動學習。僅僅一年時間,影片生成模型在物理真實度上(例如變形麵條)的進步,就超越了傳統圖學 30 年的發展。 速度:目前運行可能較慢,但具備隨算力呈指數級成長的巨大潛力。 具身縮放定律與 GR00T N1 Jim Fan 總結,傳統模擬(1.0)的速度快但受限於多樣性,而生成式模擬(2.0/3.0)雖可能起步慢但能隨算力呈指數級擴展其多樣性。這兩種模擬方式的結合,將是為下一代機器人系統提供龐大訓練資料的「核能」。這也意味著,對 AI 算力的需求只會越來越大,那些認為算力問題會迎刃而解的人需要再三思考。 藉由這些模擬技術產生的海量資料,NVIDIA 開發了「視覺語言行動模型 (Vision Language Action Model, VLA)」,能接收圖像和語言指令,並直接輸出機器人的運動控制訊號。今年 GTC 大會上黃仁勳發表的 GR00T N1 模型就是一個實例,它能在真實世界執行抓取香檳、工廠零件甚至多機器人協調等任務。 GR00T N1 已開源,NVIDIA 也計劃將未來的模型開源,以普及「實體 AI」。 物理 API:通往新世界的入口 實體 AI 的最終目標,是實現「物理 API (Physical API)」。想像一下,就像 LLM API 讓軟體能夠操作數位世界的位元 (bits) 一樣,物理 API 將賦予軟體操作現實世界的原子 (atoms) 的能力。透過這個 API,你可以讓軟體直接控制物理致動器,改變物理世界的狀態。 這將催生全新的經濟模式和應用場景: 物理提示 (Physical Prompting):不再只用文字,而是結合視覺和語言等方式更直觀地教導和指示機器人。 物理應用商店和技能經濟 (Physical App Store & Skill Economy):米其林大廚不必親自下廚,他可以「教導」機器人他的獨家烹飪技巧,並將這個技能作為服務販售,讓任何擁有機器人的家庭都能享受到米其林級的晚餐。 Jim Fan 引用黃仁勳的話再次強調,未來「每一個會移動的東西都將是自主的」。總有一天,你回家會看到乾淨的沙發和燭光晚餐,伴侶對你微笑而不是責備你沒做家事——而那一天,我們通過物理圖靈測試的時刻,很可能就像 LLM 通過圖靈測試一樣,在世人眼中「只是又一個星期二」。這正是驅動 Jim Fan 和團隊每天努力的動力。

fox hsiao

19,553 views • 1 year ago